

Paratext oferă acum utilizatorilor control asupra normalizării
O actualizare recentă a adăugat o nouă setare de normalizare.
Recomandăm utilizatorilor să verifice această setare și să stabilească dacă ar trebui făcută o modificare pentru proiectele lor.
Majoritatea proiectelor migrate din Paratext 7 vor avea normalizarea setată la „de pe„. Aceasta s-ar putea să nu fie cea mai bună setare pentru proiectul tău. Restul acestui articol descrie foarte pe scurt ce este normalizarea Unicode și semnificația celor trei setări disponibile pentru aceasta. Va depinde de tine să determini care este cea mai bună setare pentru proiectul tău.”
Scurtă descriere a normalizării Unicode
Unicode normalizare este procesul de stabilire a regulilor privind modul în care caracterele care pot fi reprezentate în mai multe moduri conform standardului Unicode ar trebui reprezentate într-un anumit proiect. Lipsa de consecvență în modul în care aceste caractere sunt reprezentate într-un proiect Paratext duce la probleme cu căutările, iar filtrele nu funcționează conform așteptărilor și poate cauza publicații cu aspect slab.
Pentru cei care nu sunt atât de familiarizați cu problemele Unicode, cred că un exemplu va fi de ajutor. Litera „e” cu accent acut, „é”, poate fi generată de computer folosind un punct Unicode (U+00E9) sau cu „e”-ul normal (U+0065) plus accentul acut (U+0301). Problema apare atunci când există un amestec al acestor două reprezentări în același proiect Paratext. Pentru oameni, toate „é”-urile sunt la fel, dar pentru Paratext sunt diferite. Prin urmare, dacă se caută punctul de cod (U+00E9), căutarea nu va găsi niciunul dintre cuvintele în care „é” a fost reprezentat de „e”-ul normal (U+0065) plus accentul acut (U+0301). Prima reprezentare este cunoscută sub numele de „compusă”, deoarece cele două părți ale caracterului sunt unite sau compuse într-un singur caracter. A doua reprezentare este cunoscută sub numele de „descompusă”, deoarece este împărțită în două părți sau descompusă.
Controlul normalizării a fost adăugat la Proprietățile și setările proiectului
Setările Proprietăților Proiectului Dialogul are acum o casetă de selectare a normalizării. (Linia 4 din captura de ecran prezentată aici.) Utilizatorul nu putea controla modul în care se realiza normalizarea în versiunile anterioare de Paratext 8.
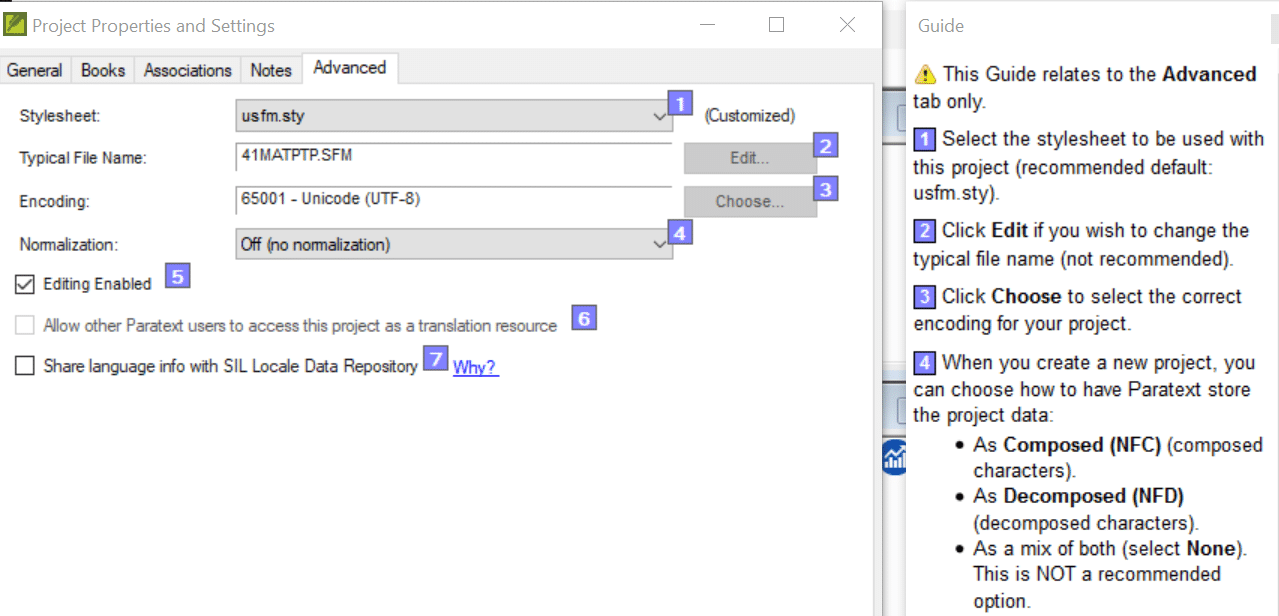
Funcția de normalizare
Funcția de normalizare are trei opțiuni: 1) Dezactivat (fără normalizare), 2) Caractere compuse (NFC) și 3) Caractere descompuse (NFD).
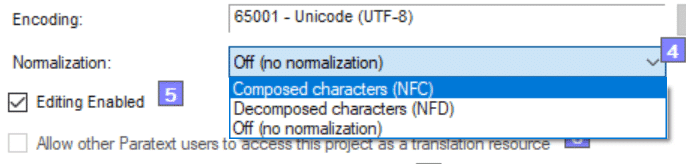
Normalizare: Dezactivat
Opțiunea implicită pentru proiectele migrate din Paratext 7 este „Dezactivat”. Când această opțiune este selectată, Paratext nu va încerca să modifice codurile caracterelor în niciun fel. Va accepta orice este tastat, chiar dacă unele computere dintr-o echipă utilizează caractere compuse (NFC), iar altele utilizează caractere descompuse (NFD).
Normalizare: Compusă
Selectarea opțiunii „Compus” va indica Paratext că, ori de câte ori un caracter este introdus ca fiind descompus (NFD), ar trebui să îl schimbe în compus atunci când este posibil. Caracterele care nu au o formă compusă disponibilă vor fi, desigur, lăsate ca fiind descompuse. Dacă se întâmplă să se introducă un caracter descompus, Paratext îl va schimba în forma sa compusă data viitoare când proiectul este salvat. Caracterele vor fi consecvente, în sensul că fiecare caracter specific va avea o singură formă în proiect.
Normalizare: Descompusă
Selectarea opțiunii „Descompus” va indica Paratext că, de fiecare dată când un caracter este introdus ca fiind compus (NFC), ar trebui să îl schimbe în descompus dacă există o reprezentare descompusă. Dacă se întâmplă să se introducă un caracter compus acolo unde există o formă descompusă, Paratext îl va schimba în forma sa descompusă data viitoare când proiectul este salvat. Caracterele vor fi consistente în sensul că orice caracter care ar putea fi reprezentat de o formă descompusă va fi consecvent.
Valori implicite de normalizare
Setarea implicită de normalizare pentru proiectele noi este „CompusăÎntrucât aceasta este o funcționalitate nouă, este recomandat să luați în considerare dacă proiectul dumneavoastră are nevoie de normalizare sau nu și, dacă da, care tip ar fi potrivit.
Setarea implicită de normalizare pentru proiectele existente este „de pe„. Când funcția a fost adăugată la Paratext 8, actualizarea nu a încercat să seteze automat normalizarea. Nici nu v-a solicitat să faceți o alegere. Dacă utilizați caractere accentuate sau aveți o tastatură personalizată, este recomandat să vă faceți timp pentru a seta normalizarea într-un mod adecvat pentru limba dvs.
Ce normalizare ar trebui să utilizez?
Prezentarea tuturor motivelor privind utilizarea caracterelor compuse sau descompuse depășește scopul acestui articol. Organizația dumneavoastră ar trebui să ofere îndrumări cu privire la această problemă. Dacă doriți să vedeți un exemplu de analiză a acestor aspecte, puteți accesa următorul link și citi despre decizia luată cu privire la codificare în Camerun:
https://langtechcameroon.info/composed-characters/
Din perspectiva Paratextului, important este să fii consecvent și să reprezinți întotdeauna un caracter în același mod. Software-ul folosește codurile subiacente și nu aspectul caracterelor atunci când își desfășoară activitatea.
Concluzie
Menținerea unei reprezentări consecvente a caracterelor va asigura că toate cuvintele relevante vor fi găsite în căutări în Paratext. Specificarea normalizării adecvate pentru proiectul dvs. poate evita, de asemenea, unele probleme de formatare care pot apărea în timpul publicării.
Specificarea unei normalizări pentru un proiect are avantajul suplimentar că diferențele dintre tastaturile dintr-o echipă sunt mai puțin importante. Un computer poate folosi caractere compuse, în timp ce altul folosește caractere descompuse, iar Paratext va face automat datele consistente pentru dvs.